NAS nebo RAID pole hlásí degraded, případně crashed, a firemní data nejsou vidět? Degraded znamená pole bez rezervy, Crashed pole, které se samo nesloží — ani jedno ještě neznamená ztracená data. Nespouštějte rebuild ani neměňte disk: u nejasného selhání se data zachraňují z bitových kopií, ne zásahem do původního pole. NAS svítí červeně, píská a v návalu adrenalinu vás napadne kliknout na „Opravit“. Právě tím se z běžného výpadku hardwaru často stává trvalá ztráta dat — největší škody nepáchá původní selhání disku, ale ukvapená svépomoc. Tento článek vysvětluje, co stavy znamenají a čemu se za každou cenu vyhnout.
Rychlý verdikt
- STOP signály: disk klepe, skřípe, píská nebo cítíte spáleninu → okamžitě vypněte a dál netestujte. Každý další pokus může stav zhoršit.
- Nedělejte slepý rebuild: když nevíte, co přesně se stalo (např. vypadly dva disky z RAID 5), rebuild může přepsat metadata a paritu.
- Nejdřív kopie: bitová kopie každého disku na zdravé médium. Pracujte vždy nad kopiemi, nikdy ne nad originály.
- Kdy je šance dobrá: disky jsou čitelné a jen se rozpadla konfigurace, nebo je pole
degradeda data jsou pořád dostupná.
Záchranu dat řeší ITHOPE
Servis PC Brno pole neskládá a záchranu dat nedělá — tenhle web vysvětluje, co se děje. Rozpadlé pole rekonstruuje z bitových kopií laboratoř ITHOPE s.r.o., která Servis PC Brno provozuje: záchrana dat z RAID pole, u konkrétních značek záchrana dat ze Synology NAS a záchrana dat z QNAP NAS. Jednoduché posouzení stavu pole může být zdarma, cenu složitější analýzy laboratoř řekne předem. Akutní případy: NONSTOP linka 775 556 063.
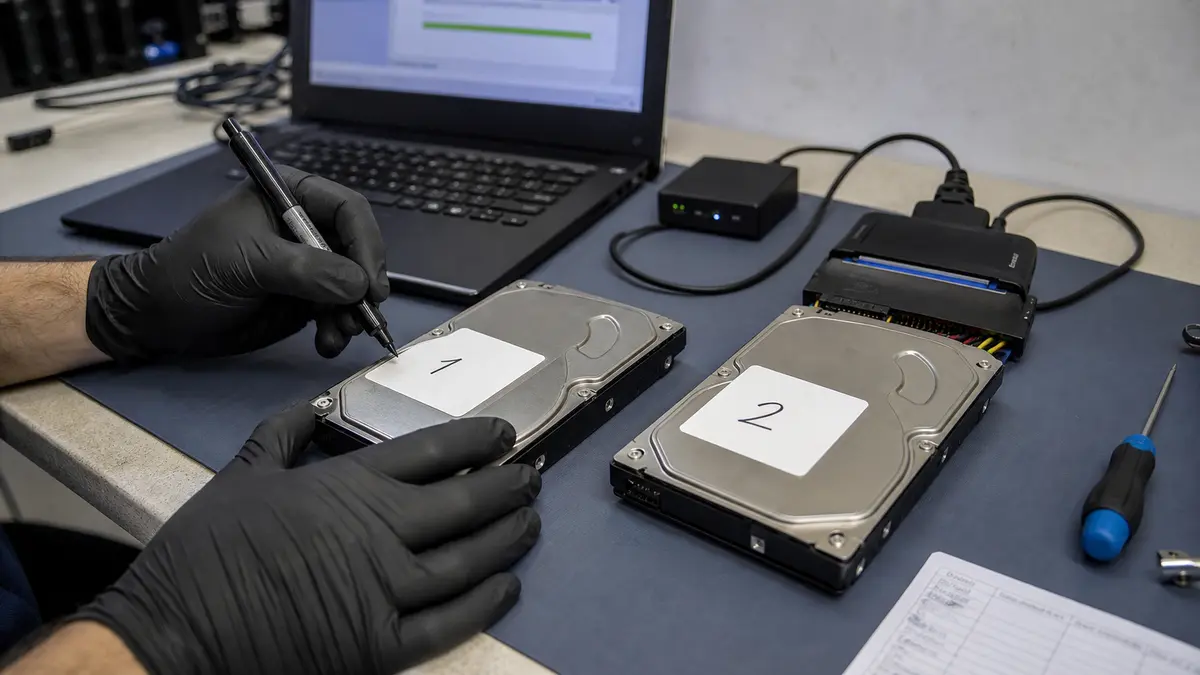
U RAID/NAS rozhoduje pořadí disků a práce nad kopiemi. Čím méně pokusů před diagnostikou, tím lepší šance na obnovu.
Rychlá odpověď: co udělat teď
Když NAS hlásí Degraded, Crashed, Missing volume, Not Initialized nebo server najednou nevidí sdílená data, největší hodnota je zachovat původní stav. RAID se často dá složit zpět, ale jen pokud se do něj mezitím zbytečně nezapisovalo.
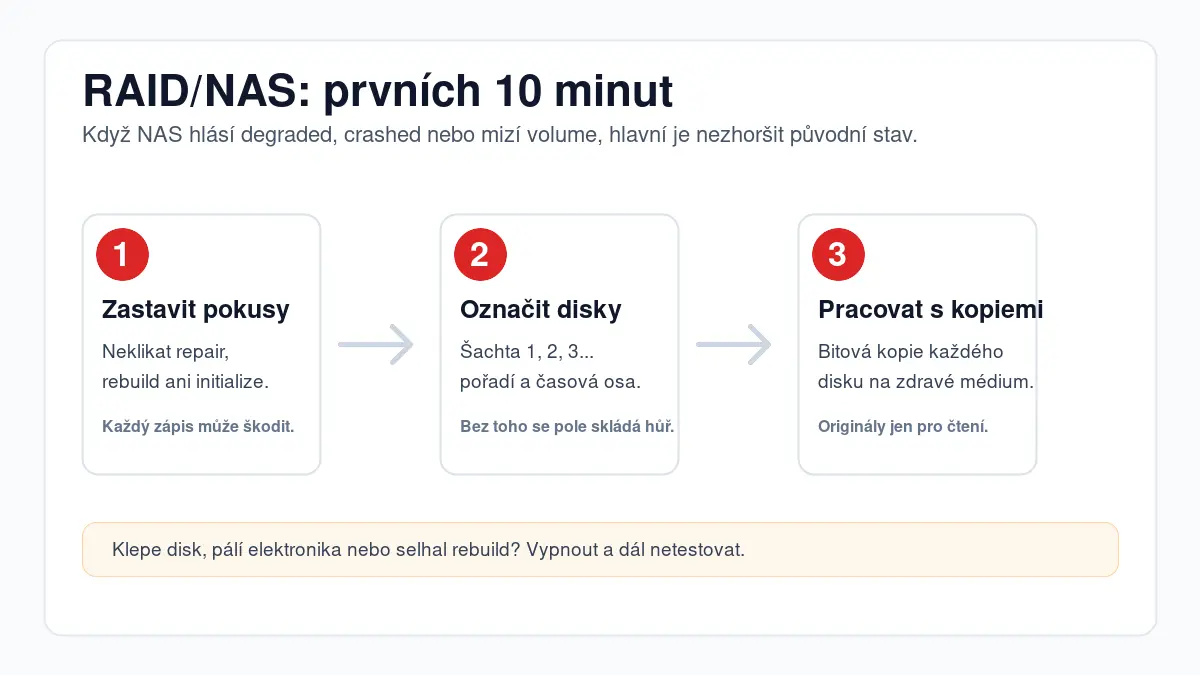
První minuty rozhodují. Zastavit pokusy, označit disky, neformátovat a pracovat až nad kopiemi.
Prakticky:
- Pokud disk klepe, píská, škrábe nebo je cítit spálenina, zařízení vypněte.
- Neklikejte na
repair,rebuild,initializeanicreate new volume. - Označte si pořadí disků podle šachet a vyfoťte aktuální stav administrace.
- Pokud jsou data pořád dostupná, kopírujte jen nejdůležitější soubory a nic dalšího na NAS nezapisujte.
- U nejasného selhání řešte záchranu dat z RAID pole dřív než další pokusy.
Bezpečný domácí krok
Tohle zvládnete sami a nic tím nezhoršíte:
- vypnout NAS nebo server, pokud disk klepe, škrábe, píská nebo je cítit spálenina,
- vyfotit stav administrace ve všech vrstvách (RAID group, storage pool, volume),
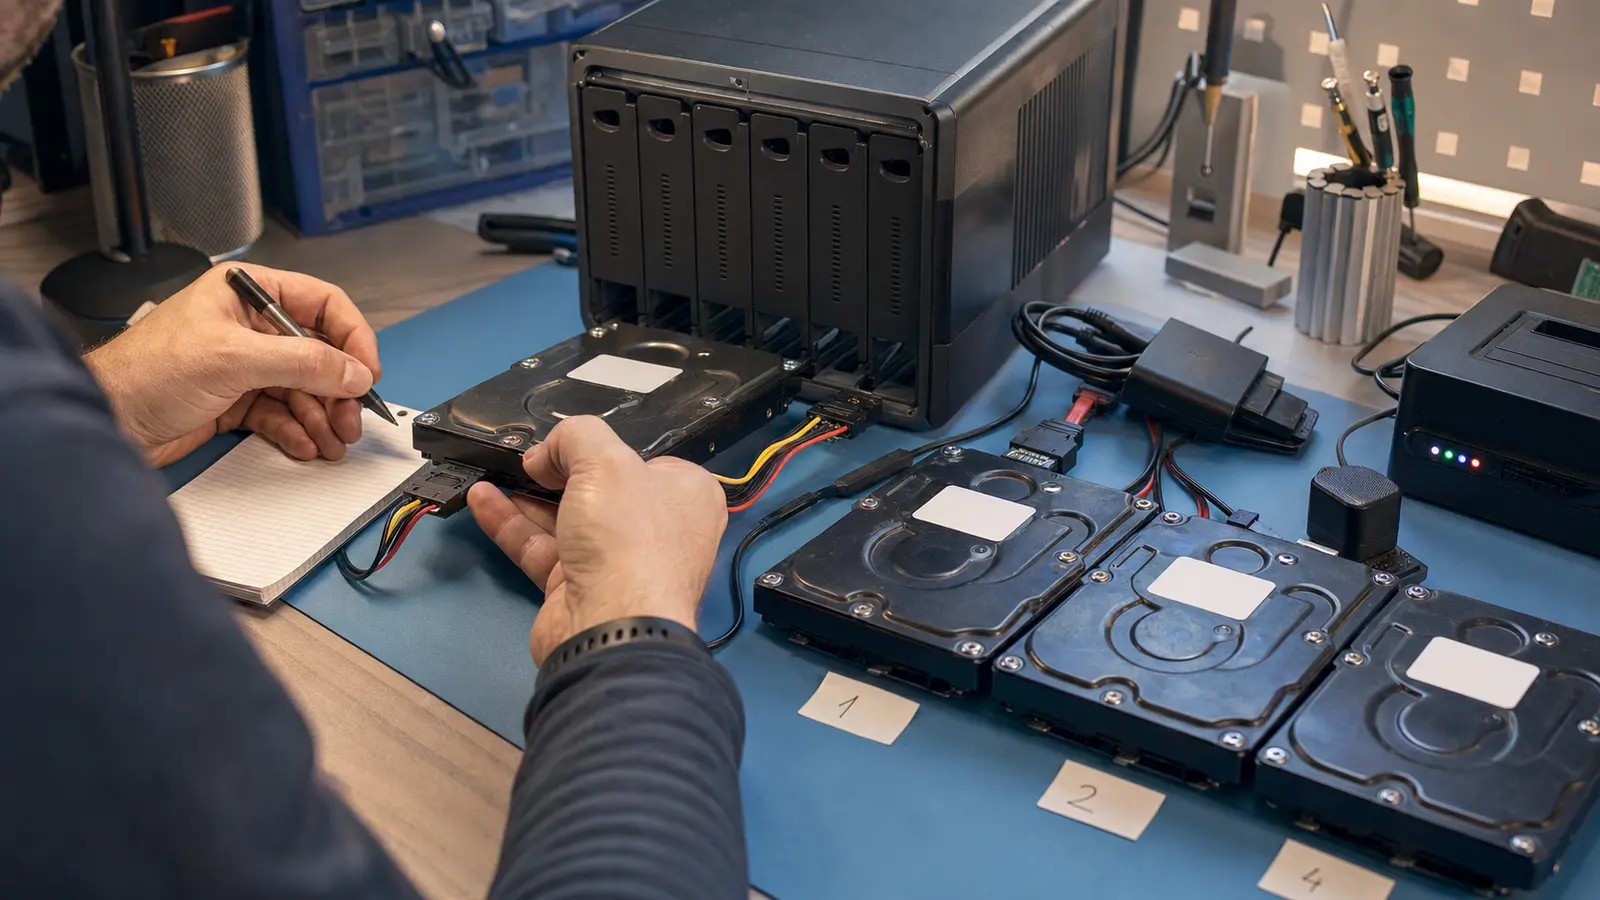
- popsat disky podle šachet, ve kterých právě jsou, a nechat je v nich,
- zkopírovat nejdůležitější soubory na externí disk, dokud jsou data ještě čitelná,
- napsat si časovou osu: co se stalo první, co jste zkusili potom.
Okamžik, kdy se už nesmí pokračovat
Hranice je jasná: jakmile nevíte, kolik disků vypadlo a v jakém pořadí, nebo pole hlásí Crashed, Not Initialized či Missing volume, nebo se SMART chyby objevují i na dalším disku — nespouštějte rebuild, repair ani initialize, nevytvářejte nový pool a neměňte pořadí disků v šachtách. Od téhle chvíle už nejde o svépomoc: každá taková operace do pole zapisuje a může přepsat metadata, ze kterých se data rekonstruují. Dál se pracuje jen nad bitovými kopiemi.
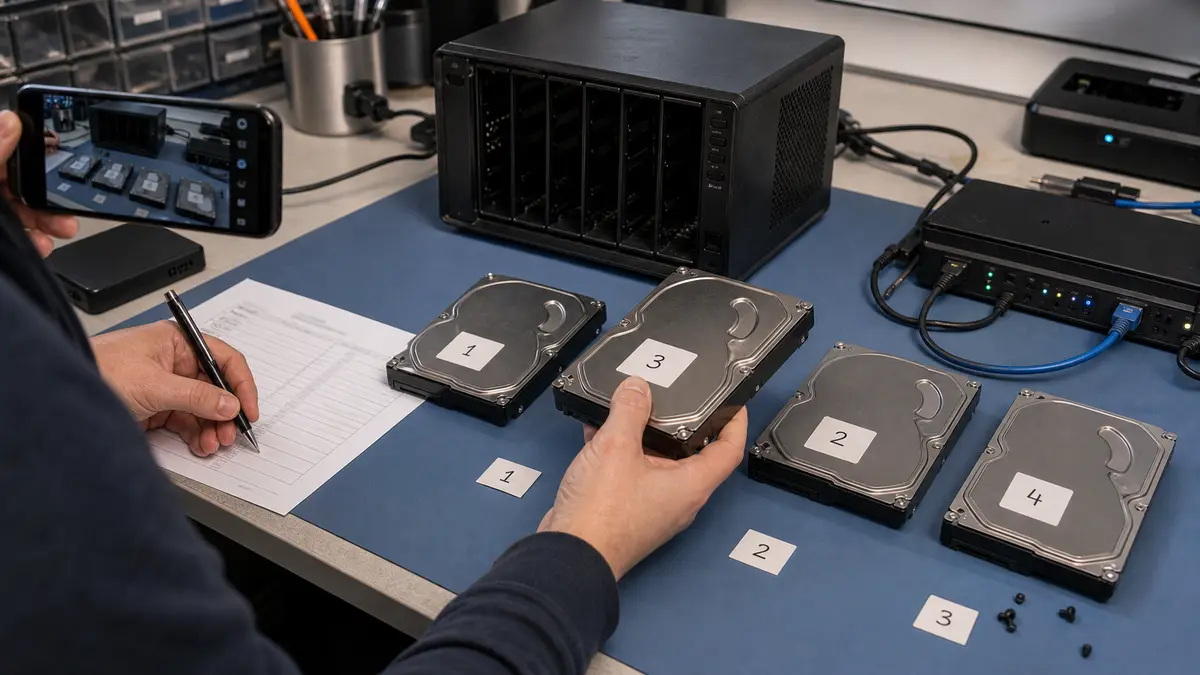
Pořadí disků je pro rekonstrukci často stejně důležité jako samotné disky. Vyndat, pomíchat a zkoušet je nejhorší varianta.
Oprava RAID pole vs. obnova dat: kde je rozdíl
Jsou to dva různé cíle a pletou se pravidelně. Oprava RAID pole — výměna disku, rebuild, repair v administraci NASu — vrací do provozu ÚLOŽIŠTĚ: pole má zase svoji redundanci a NAS jede dál. Obnova dat nechce rozchodit pole, ale dostat SOUBORY ven na jiné médium; co bude s původním NASem, se řeší až potom.
Obojí naráz nejde. Oprava pole nad nemocnými disky data ohrožuje: rebuild přečte celý povrch všech zbylých disků a zapisuje do pole, takže z disku na hraně čitelnosti udělá disk nečitelný a přepíše metadata, ze kterých by šlo pole poskládat zpět.
Rozhodovací pravidlo:
- Běžný servisní úkon (oprava pole): selhal právě jeden disk, ostatní jsou bez SMART chyb, data jsou pořád čitelná a existuje aktuální záloha.
- Laboratorní obnova dat: vypadlo víc disků, než pole toleruje; rebuild se nedokončil; disk vydává zvuky; pole hlásí
Crashed,Not InitializedneboMissing volume; nebo záloha není.
Stačí jediná položka z druhého seznamu a oprava pole přestává být bezpečná první volba.
QNAP: obnova dat z degradovaného a havarovaného pole
Co znamená Degraded a Error u RAID group
V QTS jsou nad sebou dvě vrstvy: RAID group (samotné pole poskládané z fyzických disků) a nad ní storage pool a volume, kde teprve leží souborový systém a sdílené složky. Problém se v každé z nich může hlásit jinak — RAID group může být Degraded, zatímco volume se tváří v pořádku, nebo naopak pole vypadá nedotčeně a nenaběhne volume. Než začnete cokoli dělat, projděte a vyfoťte stav ve všech vrstvách, ne jen ten první červený řádek.
Degraded znamená pole bez rezervy: chybí jeden člen, data se dopočítávají z parity a další chyba čtení už nemá čím být pokrytá. Error nebo Crashed znamená, že pole vypadlo úplně — typicky proto, že odešlo víc disků, než úroveň RAIDu toleruje. Data tím nemusí být pryč, jen k nim NAS sám nedokáže sestavit cestu.
Roli hraje i verze systému. QTS staví na linuxovém softwarovém RAIDu, zatímco QuTS hero na ZFS. To jsou jiné datové struktury i jiná metadata, takže se liší i postup obnovy — nástroje pro linuxový softwarový RAID na ZFS pool nesednou a naopak. Model a verzi systému proto uvádějte hned na začátku.
Co v QNAPu nemačkat
Tlačítka, která v běžném provozu pomáhají, mají v krizové situaci opačný efekt, než čekáte:
- Rebuild — na degradovaném poli s dalším nemocným diskem jde o hodiny čtení přes celý povrch. Typicky ho nedokončí ten druhý disk.
- Recover / obnovení neaktivní RAID group — pole to může znovu sestavit s jinými parametry, než mělo původně, a přepsat aktuální metadata.
- Initialize — smaže se tím konfigurace a začátek disků. Je to poslední věc, kterou chcete, když ještě nevíte, co se stalo.
- Vytvoření nového poolu nebo volume — na disky se začne zapisovat nová struktura přesně tam, kde leží ta stará.
Pokud nejde o jasnou výměnu jednoho vadného disku v jinak zdravém poli, správný postup je NAS vypnout, disky označit podle šachet a dál pracovat až nad bitovými kopiemi.
Synology: obnova dat ze SHR a RAID 5
Repair storage pool: kdy ano a kdy ne
Synology běží na linuxovém softwarovém RAIDu (mdadm) v kombinaci s LVM a souborovým systémem ext4 nebo btrfs. SHR (Synology Hybrid RAID) je postavené nad stejným stackem, jen umí kombinovat disky různých velikostí — pro obnovu dat to znamená, že jeden fyzický disk může nést víc RAID členů, a rekonstrukce je o to citlivější na to, aby se nic nepřepsalo.
Repair storage pool dává smysl v jediné situaci: selhal právě jeden disk, ostatní jsou prokazatelně zdravé, data jsou dostupná a máte zálohu. Jakmile se SMART chyby objevují i na dalším disku, pool hlásí Crashed, chybí volume nebo už proběhl neúspěšný pokus o opravu, přestává jít o servisní úkon — oprava v tu chvíli zatěžuje disky, které to nemusí ustát.
Proč disky ze Synology nepatří rovnou do Windows
Data ze Synology jde často přečíst na běžném Linuxu, protože stack je standardní. Ale vždy až z bitových kopií, ne z originálů — sestavování pole nad živými disky do nich zapisuje.
Do Windows disky nepatří vůbec. Windows nerozumí ext4, btrfs ani linuxovému softwarovému RAIDu, takže disk vyhodnotí jako neinicializovaný a vyskočí výzva k inicializaci. Odklepnutí této výzvy přepíše metadata pole — tabulku oddílů a začátek disku, tedy přesně to, z čeho se pole rekonstruuje. Stačí jedno kliknutí a z jednoduchého případu je složitý.
Netgear, Western Digital, Asustor a další
U Netgearu, Western Digitalu, Asustoru i dalších značek je postup stejný — bitové kopie všech disků a rekonstrukce až nad kopiemi — protože běžné NASy staví na linuxovém softwarovém RAIDu. Konkrétní rozložení vrstev a název stavu v administraci se u každého výrobce a verze systému liší, takže model a verzi systému je vždy potřeba znát dopředu.
Obnova dat z RAID 0: proč je nejrizikovější
RAID 0 je striping bez parity: soubor se rozseká na bloky a ty se střídavě ukládají na všechny disky v poli. Nic se nikam nezálohuje a nic se nedopočítává. Když vypadne jediný disk, nepřijdete o „polovinu souborů“ — chybí kusy prakticky v každém větším souboru, protože každý takový soubor je rozprostřený přes všechny členy pole.
Šance na obnovu proto stojí na dvou věcech:
- jestli je vadný disk aspoň částečně čitelný (i částečné čtení vrací velkou část bloků),
- jestli jsou známé parametry pole: pořadí disků, velikost stripu a offset.
U RAID 0 se pole nikdy nesmí zkoušet „vytvořit znovu“. Vytvořením nového pole se přepíšou právě ta metadata, ze kterých se skládání rekonstruuje, a odhadovat pořadí a stripe size pokusem se zbytkem dat je pak výrazně těžší.
RAID 0 přitom spousta lidí má, aniž by o tom věděli. Typicky dvoudisková externí pole a boxy, které se z výroby tváří jako jeden velký disk, a pole nastavená přes Intel RST v počítačích a noteboocích. Zjistí se to většinou až ve chvíli, kdy se ozve chyba.
Jak vytáhnout data z NAS po výpadku: postup podle stavu
Než sáhnete na disky, ověřte, že problém je opravdu v poli. Když se NAS jen nehlásí ve Windows, projděte nejdřív NAS nejde najít v síti — kabel, kontrolky a IP adresu.
| Stav pole | Co udělat jako první |
|---|---|
Pole degraded a data se otevírají | Zkopírovat nejdůležitější soubory na externí disk a dál na pole nezapisovat. |
Pole degraded a data se neotevírají | Vypnout a nechat diagnostikovat disky. Nespouštět repair. |
Pole hlásí Crashed nebo Missing volume | Nezasahovat a udělat bitové kopie všech disků. |
| Rebuild se nedokončil nebo skončil chybou | Zastavit a rekonstruovat pole nad kopiemi. |
| NAS nenaběhne, ale disky vypadají zdravé | Disky číst mimo NAS jen přes write-blocker, jinak je předat servisu. |
| Disk vydává zvuky | Okamžitě vypnout a už nezapínat. |
Pořadí je pokaždé stejné: nejdřív zastavit zápis, potom zjistit stav disků, teprve pak něco opravovat.
Jak poznáte problém s RAID/NAS
Ne vždy musí jít o totální kolaps. Problém se často hlásí postupně a je dobré tyto signály neignorovat.
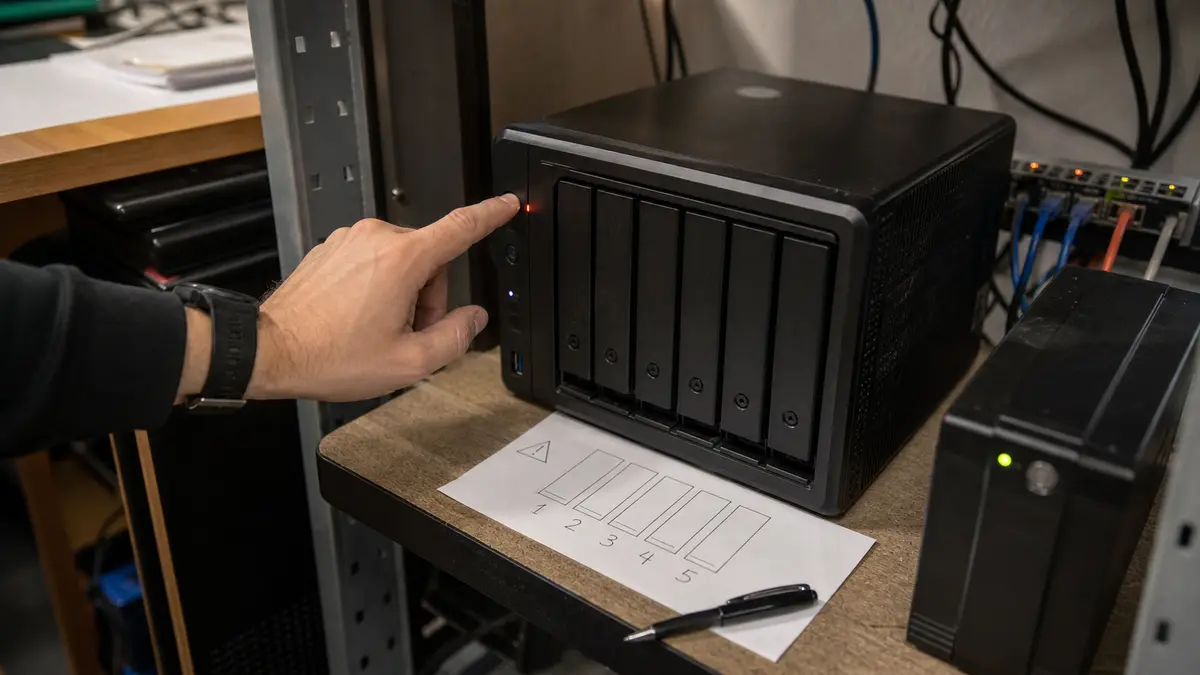
Degraded stav není konec světa, ale je to stav bez rezervy. Další chyba disku nebo špatný rebuild může rozhodnout.
- Světelná signalizace: Oranžová nebo červená LED na NASu (Synology, QNAP) nebo serveru. Může svítit trvale nebo blikat.
- Zvuková výstraha: Pravidelné pípání, které upozorňuje na degradaci pole.
- Stav pole: V administraci vidíte status
Degraded,Crashed,Read-Only,Missing volumeneboNot Initialized. - Snížený výkon: Extrémně pomalé kopírování, záseky systému, soubory nejdou otevřít.
- SMART chyby: Výstrahy v administraci na vadné sektory, vysokou teplotu nebo chyby čtení.
- Neobvyklý zvuk: Cvakání, klepání, škrábání nebo pískání. To už je kritický stav mechaniky.
Co NEdělat
Tady v servisu vidíme opakující se scénáře chyb, které z řešitelného problému udělají složitou a někdy nemožnou záchranu.
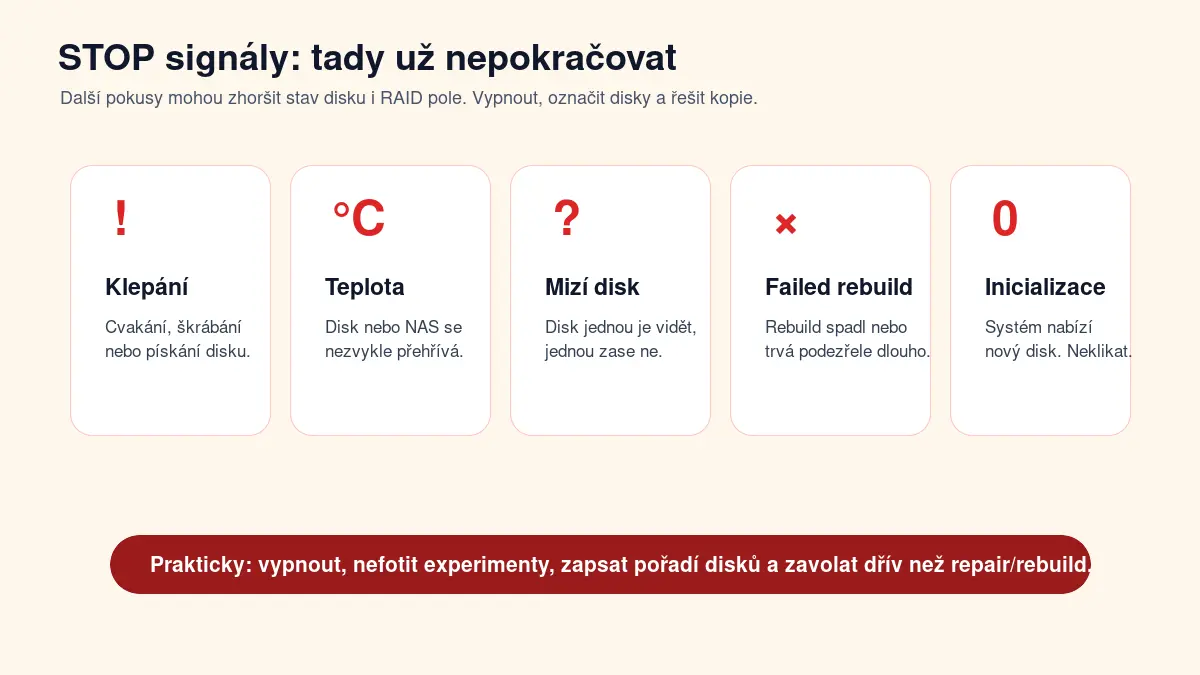
Když vidíte některý z těchto stavů, nepokračujte metodou pokus-omyl. U RAID/NAS je důležité zachovat původní stav disků.
- Slepý rebuild/repair: Pokud vypadne více disků, než je tolerance pole, nebo je jeden z disků mechanicky poškozený, rebuild zatíží zbylé disky čtením a může přepsat metadata. Je to častý důvod, proč k nám pole dorazí ve výrazně horším stavu.
- Inicializace disků: Když systém hlásí „nezinicializovaný disk“, nikdy neklikejte na inicializaci. Přepíšete tím začátek disku s klíčovými metadaty RAIDu.
- Přehazování pořadí: Vyndáte disky z NASu, očistíte je, a pak je vrátíte v jiném pořadí. Pro řadič je to chaos, který může vést k rozpadu pole.
- Další zápis: Pokud se na pole ještě dostanete, okamžitě přestaňte cokoliv zapisovat. Každý nový soubor nebo změna může přepsat bloky, které potřebujete zachránit.
- Opakované zapínání: Disk klepe? Vypnout a už nezapínat. Každý pokus o roztočení může hlavičkou nenávratně zničit datovou vrstvu.
- Recovery software nad originály: Spouštět skenování souborového systému přímo na nemocných discích je hazard. Pokud disk umírá, skenování ho dorazí.
- Rebuild bez existující zálohy: Rebuild není bezpečný krok, po kterém se nic nemůže stát. Je to několikahodinový až několikadenní zátěžový test zbylých disků — a ty jsou stejně staré jako ten, který právě selhal, a mají za sebou stejný provoz.
Proč každý další pokus snižuje šanci: Rebuild i sken recovery softwarem znamenají čtení přes celý povrch všech disků. U disku s vadnými sektory nebo poškozenou mechanikou to jeho stav dál zhoršuje — přibývají další nečitelná místa a hlavičky dostávají zabrat přesně tam, kde by měly číst co nejšetrněji. Inicializace a znovuvytvoření pole jsou na tom hůř: přepisují právě ta metadata, ze kterých se rekonstrukce dělá. Proto čím míň pokusů proběhne před diagnostikou, tím víc možností zůstává otevřených.
RAID 0/1/5/6/10: co která úroveň přežije
Každá úroveň RAIDu má jinou toleranci k výpadku disků. Tady je přehled, se kterým v servisu denně pracujeme.
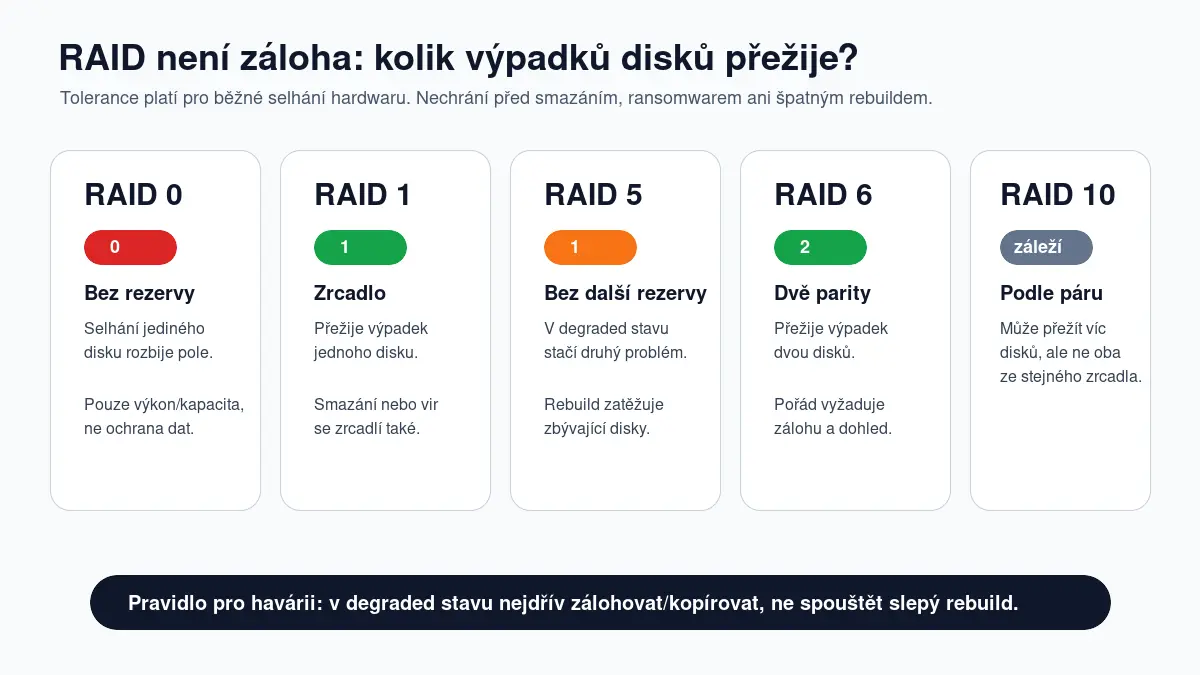
Kolik výpadků disků která úroveň RAID přežije — a kde už nezbývá rezerva.
| RAID | Co vydrží | Praktický komentář |
|---|---|---|
| RAID 0 | 0 disků | Žádná redundance. Selhání jediného disku rozbije celé pole. Data jsou rozprostřena (striping), bez všech členů je to skládačka bez půlky dílků. |
| RAID 1 | 1 disk (zrcadlo) | Přežije výpadek jednoho disku. Pozor, smazání souboru nebo napadení ransomwarem se okamžitě zrcadlí i na druhý disk. RAID 1 chrání jen proti selhání HW, ne proti chybě uživatele. |
| RAID 5 | 1 disk | V degraded režimu už nemáte žádnou rezervu. Při selhání druhého disku nebo chybě čtení při rebuildu je pole kriticky ohrožené a data mohou být nedostupná. U velkých dnešních disků je rebuild dlouhý a rizikový. |
| RAID 6 | 2 disky | Odolnější varianta. I při výpadku jednoho disku stále máte paritu na druhém. Rebuild je ale extrémně dlouhý a náročný, chyby čtení na zbylých discích ho mohou zhatit. |
| RAID 10 | Záleží na páru | Kombinace zrcadlení a stripu. Přežije výpadek více disků, pokud nejsou ze stejného zrcadleného páru. Pokud odejdou oba disky z jednoho páru, pole je mrtvé. |
Kdy jde data zachránit a kdy už je šance malá
Následující tabulka ukazuje typické scénáře, se kterými se setkáváme. Neslibujeme zázraky, ale ukazuje, co hraje roli.
| Scénář | Šance na obnovu | Co je potřeba |
|---|---|---|
| Rozpadlá konfigurace (disky OK, pole se nenašlo) | Velmi vysoká | Správně určit parametry pole (pořadí, stripe size, offset) a složit ho softwarově nad kopiemi. |
| Degraded pole, disky čitelné | Vysoká | Udělat kopie všech disků, ověřit jejich zdraví, a teprve pak řešit výměnu a rebuild. |
| Vadný NAS/řadič, disky OK | Vysoká | Data jdou často vyčíst na běžném Linuxu. Ale vždy až z kopií, ne z originálů. |
| Přeformátování bez velkého přepisu | Střední až vysoká | Záleží na typu formátu a souborovém systému. Metadata jsou přepsaná, ale data často zůstávají. |
| Opakované výpadky, vadné sektory | Střední až nízká | Nutná práce v laboratoři. Čtení přes vadné sektory je pomalé a rizikové, vyžaduje specializovaný hardware. |
| Nedokončený nebo špatně spuštěný rebuild | Nízká až velmi nízká | Došlo k přepisu metadat a části dat. Často jsou data fragmentovaná a bez logické struktury. |
| Klepání/klikání mechaniky | Nízká (záleží na rozsahu poškození) | Nutný zásah v čistých prostorách, výměna čtecích hlaviček. Každé další zapnutí šanci snižuje. |
Reálné scénáře, které často řešíme
Ne každý pád NASu je stejný. Dva případy mohou na obrazovce vypadat podobně, ale technicky se řeší úplně jinak.
Synology SHR nebo RAID 5 po výpadku jednoho disku Pokud je pole jen degraded, data jsou čitelná a ostatní disky jsou zdravé, může dávat smysl standardní výměna vadného disku. Jakmile se ale objevují SMART chyby i na dalším disku, přestává to být běžný servisní repair a začíná záchrana dat.
QNAP po neúspěšném rebuildu Tohle je horší situace. Rebuild zatížil zbývající disky, mohl přepsat část parity a metadata už nemusí odpovídat původnímu stavu. Tady je zásadní nezkoušet další repair, ale udělat obrazy disků a analyzovat, co se přesně přepsalo.
RAID 0 v externím boxu RAID 0 nemá žádnou redundanci. Když chybí jeden disk, chybí část dat. Šance závisí na tom, jestli disk jde ještě aspoň částečně číst a jestli známe parametry pole. U důležitých dat je RAID 0 špatná volba.
NAS po ransomwaru RAID nepomůže, pokud ransomware zašifruje sdílené soubory. Pole zůstane technicky zdravé, ale data jsou logicky poškozená. V takovém případě řešíme snapshoty, zálohy, stínové kopie nebo částečnou obnovu podle typu útoku.
Diagnostika ukáže, jestli je disk vhodný pro další čtení, nebo jestli je nutné postupovat pomaleji a šetřit každý pokus.
Bezpečný postup obnovy
Laboratoř se při obnově pole drží přesně daného postupu, aby se nic nepokazilo. Níže je princip, podle kterého se bezpečná obnova dělá — ať víte, co od ní čekat. U vadných disků nebo nejasného rozpadu pole ho ale doma nedoporučujeme zkoušet naslepo.
Bitová kopie je základ bezpečné práce. Skenování a rekonstrukce běží nad kopií, ne nad původním diskem.
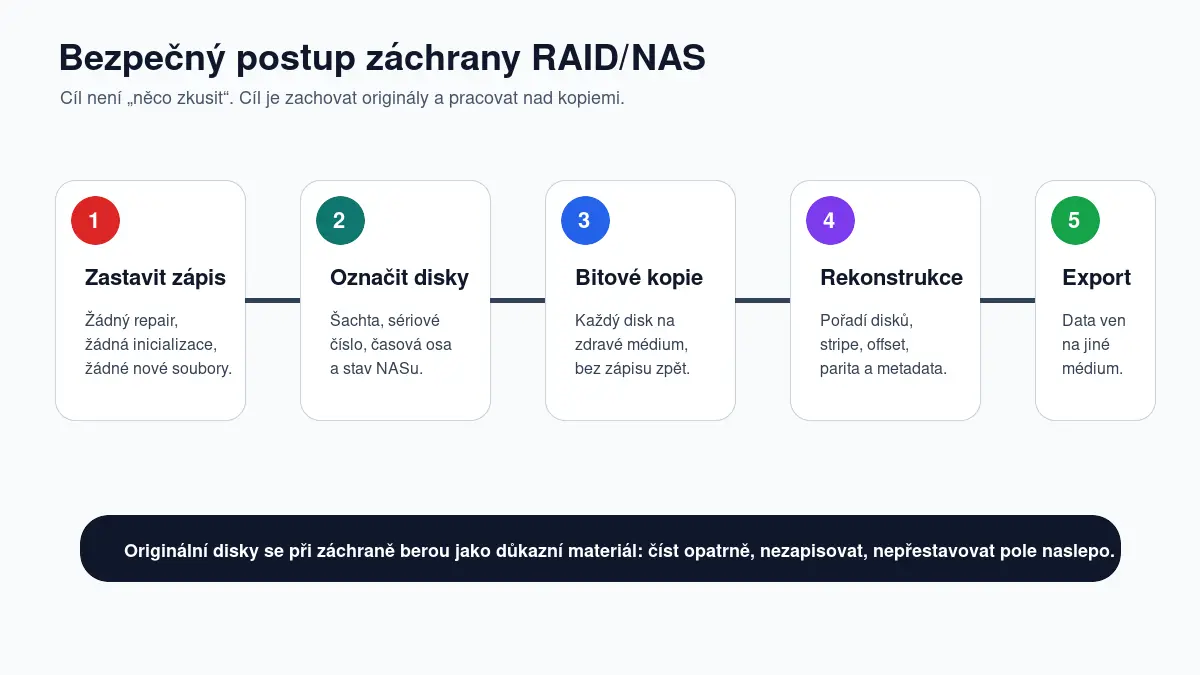
Bezpečný postup: nejdřív bitové kopie všech disků, rekonstrukce a export až nad nimi — originály se nedotýkáme.
- Evidence a dokumentace: Zapište si přesné pořadí disků (šachta 1, 2, 3…), jejich sériová čísla a co se dělo – časová osa událostí. To je pro rekonstrukci často zásadní.
- Bitová kopie (imaging): Každý disk se připojí přes hardwarový write-blocker (ochrana proti zápisu) a vznikne jeho kompletní bitová kopie na zdravé, prázdné médium. U vadných disků se používají specializované nástroje, které umí číst přes vadné sektory.
- Kontrola čitelnosti kopií: Ověří se, že kopie jsou kompletní a bez chyb. Dál se pracuje výhradně s nimi.
- Rekonstrukce parametrů: Z metadat se hledají správné parametry – pořadí disků, velikost stripu (stripe size), offset, typ parity a rotaci, typ metadat (např. mdadm, LVM, Intel Matrix).
- Složení pole a export dat: Pole se virtuálně složí jen pro čtení (read-only), ověří se struktura souborového systému a data se exportují na jiné, zdravé médium.
Cílem není „rozchodit NAS za každou cenu“. Cílem je dostat data bezpečně ven na jiné médium a teprve potom řešit nové úložiště.
Synology/QNAP specifika
Každý výrobce má svá specifika, která musíme při záchraně znát.
- Synology: Většinou používá Linuxový softwarový RAID (
mdadm) v kombinaci s LVM (Logical Volume Manager) a souborovým systémemext4nebobtrfs. Jejich vlastní technologie SHR (Synology Hybrid RAID) je také postavená nad tímto stackem. Výhodou je, že data jdou často připojit a číst i na běžném Linuxovém PC, ale opakujeme – vždy až z kopií. - QNAP: Používá vlastní vrstvy v rámci QTS nebo QuTS (ZFS) systému. Můžete narazit na storage pooly, RAID groupy a specifické konfigurace. I zde platí, že vendor repair je legitimní servisní postup jen v případě, že jste si naprosto jisti, že zbývající disky jsou fyzicky zdravé a jde jen o standardní výměnu vadného kusu v degraded poli. V jakékoliv jiné, krizové situaci je bezpečnější vše zastavit a řešit to přes kopie.
Cena, čas a co ovlivní úspěšnost
U RAID a NAS záchrany dat nejde dopředu férově slíbit pevnou cenu bez diagnostiky. Rozdíl je obrovský: jinak se řeší rozpadlá konfigurace se zdravými disky a jinak pole po neúspěšném rebuildu, vadných sektorech nebo mechanicky poškozeném disku.
Úspěšnost nejvíc ovlivní:
- kolik disků fyzicky selhalo,
- jestli někdo spustil rebuild nebo inicializaci,
- zda existuje aktuální záloha,
- zda jsou známé šachty a pořadí disků,
- typ RAIDu, souborového systému a NAS platformy,
- jestli se po havárii na pole dál zapisovalo.
První posouzení začíná tím, že zjistíme stav disků a konfigurace. Teprve potom dává smysl říct, jestli půjde o běžnou obnovu, složitější rekonstrukci RAIDu, nebo laboratorní zásah.
Pevná cena za obnovu dat z RAID nebo NAS proto dopředu nedává smysl. Konkrétní číslo jde říct až ve chvíli, kdy je jasné, kolik disků je vadných, jestli je potřeba laboratorní čtení a v jakém stavu je konfigurace pole. U záchrany dat z RAID pole v laboratoři ITHOPE může být jednoduché posouzení zdarma; složitější analýza je placená a cenu laboratoř sdělí dřív, než začne.
Proč se původní pole neopravuje jako první
U běžného servisu dává smysl opravit zařízení. U záchrany dat je pořadí opačné: nejdřív zachránit data, potom řešit zařízení. Původní pole může být v nestabilním stavu a každá operace, která do něj zapisuje, může zhoršit výsledek.
Dokud nejsou data v bezpečí, vynechávají se tyto kroky:
- rebuild nad originálními disky,
- oprava souborového systému přímo na poli,
- inicializace nebo vytvoření nového volume,
- sken recovery softwarem nad vadným originálem,
- opakované zapínání disku s mechanickou závadou.
Jakmile jsou data exportovaná, je čas rozhodnout, jestli původní NAS opravit, postavit nové úložiště, vyměnit disky, změnit RAID úroveň nebo nastavit lepší zálohování.
Co připravit, než pole předáte laboratoři
Čím lepší informace má laboratoř na začátku, tím méně času padne na rekonstrukci. Ideální je přivézt celý NAS nebo server v původním stavu. Pokud to nejde, pomůže aspoň přesná dokumentace.
Připravte si:
- model NASu nebo serveru,
- počet disků a jejich původní pořadí ve slotech,
- fotku administrace se stavem pole,
- časovou osu: co se stalo jako první, co jste zkusili potom,
- informaci, jestli proběhl rebuild, repair, inicializace nebo výměna disku,
- cílové médium pro zachráněná data.
Po obnově dat má smysl hned nastavit zálohování dat, protože RAID sám o sobě záloha není.
Časté dotazy
Mám vyměnit vadný disk a kliknout repair? Pouze pokud jste si na 100 % jisti, že selhal právě jeden disk a všechny ostatní jsou v perfektním stavu (bez SMART chyb, vadných sektorů). V opačném případě je to riskantní operace, která může pole zničit. Když si nejste jistí, nedělejte to.
Můžu disky připojit k Windows? Ne. Windows nativně nerozumí souborovým systémům jako ext4, btrfs, ani softwarovému RAIDu z Linuxu (mdadm). Pokus o připojení může vést k výzvě k inicializaci disku, což by mělo fatální následky.
NAS ukazuje data, ale hlásí degraded — co teď? Okamžitě zálohujte nejdůležitější data na externí disk, pokud je to možné. Pak řešte výměnu disku. Nezapomínejte, že v degraded stavu nemáte žádnou ochranu proti selhání dalšího disku.
Musím přivézt celý NAS, nebo jen disky? Ideálně předejte celý NAS. Pro rekonstrukci je důležitá znalost modelu a verze systému. Pokud vezete jen disky, je kriticky důležité mít přesně označené jejich pořadí (šachta 1, 2, 3…). Bez toho se rekonstrukce extrémně komplikuje.
Pomůže RAID, když jsem něco omylem smazal? Ne. RAID chrání proti výpadku hardwaru, ale není to záloha. Před smazáním souborů, chybou uživatele nebo ransomwarem vás neochrání. I pro NAS a servery platí pravidlo zálohování 3-2-1.
Oficiální návody výrobců vs. záchrana dat
Synology i QNAP mají oficiální postupy pro opravu degraded pole. Ty dávají smysl, pokud je jasné, že selhal právě jeden disk, ostatní disky jsou zdravé a máte aktuální zálohu. Pokud si tím jistí nejste, je bezpečnější zastavit a nejdřív udělat kopie. Pro orientaci: Synology popisuje repair storage pool, QNAP popisuje obnovu RAID group ve stavu degraded. Tyto návody nejsou totéž jako záchrana dat po nejasné havárii.
Pokud váš NAS nebo server hlásí chybu, zachovejte klid a hlavně nic nezkoušejte naslepo. Správně popsané pořadí disků a časová osa událostí je půlka úspěchu. Samotnou obnovu dělá laboratoř ITHOPE — záchrana dat z RAID pole, údržbu a opravy funkčních NASů řeší servis NAS v Brně; akutní případy NONSTOP linka 775 556 063. A až budete mít data v bezpečí, mrkněte na tipy pro správné zálohování, protože RAID sám o sobě záloha opravdu není.
Nechce se vám to řešit svépomocí?
Objednejte diagnostiku v Brně — cenu řekneme předem, bez vašeho souhlasu se do ničeho nepouštíme.